xv6 文件系统手册和代码阅读笔记
一、手册阅读
分为六层实现,
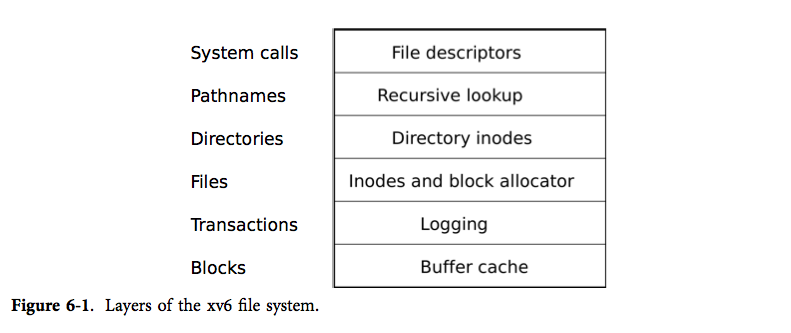
最下面一层通过块缓冲读写IDE盘,同步了对磁盘的访问,保证同时只有一个内核进程可以修改磁盘块。第二层使得更高层的接口可以将对磁盘的更新按会话打包,通过会话的方式来保证这些操作是原子操作(要么都被应用,要么都不被应用)。第三层提供无名文件,每一个这样的文件由一个 i node 和一连串的数据块组成。第四层将目录实现为一种特殊的 i node,它的内容是一连串的目录项,每一个目录项包含一个文件名和对应的 i node。第五层提供了层次路经名,这一层通过递归的方式来查询路径对应的文件。最后一层将许多 UNIX 的资源(如管道,设备,文件等)抽象为文件系统的接口。
块缓冲层
两个任务:(1)同步对磁盘的访问,使得对于每一个块,同一时间只有一份拷贝放在内存中并且只有一个内核线程使用这份拷贝;(2)缓存常用的块以提升性能。
块缓冲提供的的主要接口是 bread 和 bwrite;前者从磁盘中取出一块放入缓冲区,后者把缓冲区中的一块写到磁盘上正确的地方。当内核处理完一个缓冲块之后,需要调用 brelse 释放它。
块缓冲仅允许最多一个内核线程引用它,以此来同步对磁盘的访问,如果一个内核线程引用了一个缓冲块,但还没有释放它,那么其他调用 bread 的进程就会阻塞。文件系统的更高几层正是依赖块缓冲层的同步机制来保证其正确性。
块缓冲有固定数量的缓冲区,这意味着如果文件系统请求一个不在缓冲中的块,必须换出一个已经使用的缓冲区。置换策略使用的是 LRU。
日志层
日志设计
xv6 通过简单的日志系统来解决文件操作过程当中崩溃所导致的问题。一个系统调用并不直接导致对磁盘上文件系统的写操作,相反,他会把一个对磁盘写操作的描述包装成一个日志写在磁盘中。当系统调用把所有的写操作都写入了日志,它就会写一个特殊的提交记录到磁盘上,代表一次完整的操作。从那时起,系统调用就会把日志中的数据写入磁盘文件系统的数据结构中。在那些写操作都成功完成后,系统调用就会删除磁盘上的日志文件。
对日志的常见使用方法像下面这样
begin_trans();
...
bp = bread(...);
bp->data[...] = ...;
log_write(bp);
...
commit_trans();begin_trans 会一直等到它独占了日志的使用权后返回。
log_write像是 bwrite 的一个代理;它把块中新的内容记录到日志中,并且把块的扇区号记录在内存中。log_write 仍将修改后的块留在内存中的缓冲区中,因此相继的本会话中对这一块的读操作都会返回已修改的内容。log_write 能够知道在一次会话中对同一块进行了多次读写,并且覆盖之前同一块的日志。
commit_trans 将日志的起始块写到磁盘上,这样在这个时间点之后的系统崩溃就能够恢复,只需将磁盘中的内容用日志中的内容改写。commit_trans 调用 install_trans(4221) 来从日志中逐块的读并把他们写到文件系统中合适的地方。最后 commit_trans 会把日志起始块中的计数改为0,这样在下次会话之前的系统崩溃就会使得恢复代码忽略日志。
recover_from_log 在 initlog 中被调用,而 initlog 在第一个用户进程开始前的引导过程中被调用。它读取日志的起始块,如果起始块说日志中有一个提交了的会话,它就会仿照 commit_trans 的行为执行,从而从错误中恢复。
filewrite 中有一个使用了日志的例子:
begin_trans();
ilock(f->ip);
r = writei(f->ip, ...);
iunlock(f->ip);
commit_trans();在一个用于将一次大的写操作拆分成一些会话的循环中找到了这段代码,在每一次会话中这段只会写部分块,因为日志的大小是有限固定的。对 writei 的调用会在一次会话中写很多的块:文件的 i 节点,一个或多个位图块,以及一些数据块。在 begin_trans 之后再执行 ilock 是一种避免死锁的办法:因为每次会话都已经有一个锁保护了,因此在持有两个锁的时候,要保证一定的加锁顺序。
i node
i 节点这个术语可以有两个意思。它可以指的是磁盘上的记录文件大小、数据块扇区号的数据结构。也可以指内存中的一个 i 节点,它包含了一个磁盘上 i 节点的拷贝,以及一些内核需要的附加信息。
所有的磁盘上的 i 节点都被打包在一个称为 i 节点块的连续区域中。每一个 i 节点的大小都是一样的,所以对于一个给定的数字n,很容易找到磁盘上对应的 i 节点。事实上这个给定的数字就是操作系统中 i 节点的编号。
磁盘上的 i 节点由结构体 dinode定义。type 域用来区分文件、目录和特殊文件的 i 节点。如果 type 是0的话就意味着这是一个空闲的 i 节点。nlink 域用来记录指向了这一个 i 节点的目录项,这是用于判断一个 i 节点是否应该被释放的。size 域记录了文件的字节数。addrs 数组用于这个文件的数据块的块号。
// On-disk inode structure
struct dinode {
  short type;           // File type, files, directories, or special files (devices)
                        // 0 indicates dinode is free
  short major;          // Major device number (T_DEVICE only)
  short minor;          // Minor device number (T_DEVICE only)
  short nlink;          // Number of links to inode in file system
                        // won’t free an inode if its link count is greater than 0
                        // 统计指向这个inode的目录条目(硬链接数)
                        // 用于指示何时磁盘上的inode和它对应的data blocks应该被释放
  uint size;            // Size of file (bytes)
                        // the number of bytes of content in the file
  uint addrs[NDIRECT+1];   // Data block addresses
                           // records the block numbers of the disk blocks holding the file’s content.
                 // NDIRECT = 12, 12个直接块,第13个是一级间接块
                           // 默认大小为(12+256)*BISZE = 268KB
}内核在内存中维护活动的 i 节点。结构体 inode是磁盘中的结构体 dinode 在内存中的拷贝。内核只会在有 C 指针指向一个 i 节点的时候才会把这个 i 节点保存在内存中。ref 域用于统计有多少个 C 指针指向它。如果 ref 变为0,内核就会丢掉这个 i 节点。iget 和 iput 两个函数申请和释放 i 节点指针,修改引用计数。i 节点指针可能从文件描述符产生,从当前工作目录产生,也有可能从一些内核代码如 exec 中产生。
// in-memory copy of an inode(struct dinode)
// kernel stores an inode in memory only if there are C pointers referring to that inode
struct inode {
  uint dev;           // Device number
  uint inum;          // Inode number
  int ref;            // Reference count
                      // 在内存中指向该inode的指针数,注意区分和dinode的nlink
                      // ref大于0,就会继续在icache中保存该inode,而且该缓存条目不会被置换成别的inode
                      // ref为0时,内核就清除该inode在icache中的副本
                      // nlink是硬链接,断电之后还会保存在磁盘里面
                      // 而ref是内存里面的数据结构,断电之后就会消失
  struct sleeplock lock; // protects everything below here
                         // ensures exclusive access to the inode’s fields as well as to the inode’s file or directory content blocks.
  int valid;          // inode has been read from disk?

  //以下为struct dinode的成员
  short type;         // copy of disk inode
  short major;
  short minor;
  short nlink;
  uint size;
  uint addrs[NDIRECT+1];
};持有 iget 返回的 i 节点的指针将保证这个 i 节点会留在缓存中,不会被删掉(特别地不会被用于缓存另一个文件)。因此 iget 返回的指针相当一种较弱的锁,虽然它并不要求持有者真的锁上这个 i 节点。文件系统的许多部分都依赖于这个特性,一方面是为了长期地持有对 i 节点的引用(比如打开的文件和当前目录),一方面是在操纵多个 i 节点的程序中避免竞争和死锁(比如路径名查找)。
iget 返回 i 节点可能没有任何有用的内容。为了保证它持有一个磁盘上 i 节点的有效拷贝,程序必须调用ilock。它会锁住 i 节点(从而其他进程就无法使用它)并从磁盘中读出 i 节点的信息(如果它还没有被读出的话)。iunlock 释放 i 节点上的锁。把对i 节点指针的获取和 i 节点的锁分开避免了某些情况下的死锁,比如在目录查询的例子中,数个进程都可以通过 iget 获得一个 i 节点的 C 指针,只有一个进程可以锁住一个 i 节点。
i 节点缓存只会缓存被 C 指针指向的 i 节点。它主要的工作是同步多个进程对 i 节点的访问而非缓存。如果一个 i 节点频繁被使用,块缓冲可能会把它保留在内存中,即使 i 节点缓存没有缓存它。
文件描述符层
xv6 给每个进程都有一个自己的打开文件表,每一个打开文件都由结构体 file表示,它是一个对 i 节点或者管道和文件偏移的封装。每次调用 open 都会创建一个新的打开文件(一个新的 file结构体)。如果多个进程相互独立地打开了同一个文件,不同的实例将拥有不同的 i/o 偏移。另一方面,同一个文件可以(同一个file结构体)可以在一个进程的文件表中多次出现,同时也可以在多个进程的文件表中出现。当一个进程用 open 打开了一个文件而后使用 dup,或者把这个文件和子进程共享就会导致这一点发生。对每一个打开的文件都有一个引用计数,一个文件可以被打开用于读、写或者二者。readable域和writable域记录这一点。
系统中所有的打开文件都存在于一个全局的文件表 ftable 中。这个文件表有一个分配文件的函数(filealloc),有一个重复引用文件的函数(filedup),释放对文件引用的函数(fileclose),读和写文件的函数(fileread 和 filewrite )。
Filealloc 扫描整个文件表来寻找一个没有被引用的文件(file->ref == 0)并且返回一个新的引用;filedup增加引用计数;fileclose减少引用计数。当一个文件的引用计数变为0的时候,fileclose就会释放掉当前的管道或者i 节点(根据文件类型的不同)。
函数filestat,fileread,filewrite 实现了对文件的 stat,read,write 操作。filestat (5302)只允许作用在 i 节点上,它通过调用 stati 实现。fileread 和 filewrite 检查这个操作被文件的打开属性所允许然后把执行让渡给 i 节点的实现或者管道的实现。如果这个文件代表的是一个 i 节点,fileread和 filewrite 就会把 i/o 偏移作为该操作的偏移并且往前移。管道没有偏移这个概念。回顾一下 i 节点的函数需要调用者来处理锁。i 节点锁有一个方便的副作用那就是读写偏移会自动更新,所以同时对一个文件写并不会覆盖各自的文件,但是写的顺序是不被保证的,因此写的结果可能是交织的(在一个写操作的过程中插入了另一个写操作)。
二、代码阅读
文件系统部分 buf.h fcntl.h stat.h fs.h file.h ide.c bio.c log.c fs.c file.c sysfile.c exec.c
1.buf.h:对xv6中磁盘块数据结构进行定义,块大小为512字节。
// xv6中磁盘块数据结构,块大小512字节
struct buf {
  int flags; // DIRTY, VALID
  uint dev;
  uint sector; // 对应扇区
  struct buf *prev; // LRU cache list
  struct buf *next; // 链式结构用于连接
  struct buf *qnext; // disk queue
  uchar data[512];
};
#define B_BUSY  0x1  // buffer is locked by some process
#define B_VALID 0x2  // buffer has been read from disk
#define B_DIRTY 0x4 // buffer needs to be written to disk2.fcntl.h:宏定义操作权限。
#define O_RDONLY  0x000 // 只读
#define O_WRONLY  0x001 // 只写
#define O_RDWR    0x002 // 读写
#define O_CREATE 0x200 // 创建3.stat.h:声明文件或目录属性数据结构。
#define T_DIR  1   // Directory
#define T_FILE 2   // File
#define T_DEV  3   // Device

struct stat {
  short type;  // Type of file
  int dev;     // File system's disk device
  uint ino;    // Inode number
  short nlink; // Number of links to file
  uint size;   // Size of file in bytes
};4.fs.h / fs.c:声明超级块、dinode、文件和目录数据结构,以及相关的宏定义。
#define ROOTINO 1  // root i-number
#define BSIZE 512  // block size

// File system super block
struct superblock {
  uint size;         // Size of file system image (blocks)
  uint nblocks;      // Number of data blocks
  uint ninodes;      // Number of inodes.
  uint nlog;         // Number of log blocks
};

#define NDIRECT 12
#define NINDIRECT (BSIZE / sizeof(uint))
#define MAXFILE (NDIRECT + NINDIRECT)

// 磁盘上inode节点体现形式
// On-disk inode structure
struct dinode {
  short type;           // File type
  short major;          // Major device number (T_DEV only)
  short minor;          // Minor device number (T_DEV only)
  short nlink;          // Number of links to inode in file system
  uint size;            // Size of file (bytes)
  uint addrs[NDIRECT+1];   // Data block addresses
};

// Inodes per block.
#define IPB           (BSIZE / sizeof(struct dinode))

// Block containing inode i
#define IBLOCK(i)     ((i) / IPB + 2)

// Bitmap bits per block
#define BPB           (BSIZE*8)

// Block containing bit for block b
#define BBLOCK(b, ninodes) (b/BPB + (ninodes)/IPB + 3)

// Directory is a file containing a sequence of dirent structures.
#define DIRSIZ 14

// 文件或目录据结构,目录本身是以文件的方式存储到磁盘上的,叫做目录文件。
struct dirent {
  ushort inum; // i节点
  char name[DIRSIZ]; // 文件或目录名
};5.file.h:声明inode、file数据结构。
struct file {
  // 分为管道文件,设备文件,普通文件
  enum { FD_NONE, FD_PIPE, FD_INODE } type;
  int ref; // reference count
  char readable;
  char writable;
  struct pipe *pipe;
  struct inode *ip; // 指向inode节点
  uint off;
};

// 在内存中inode节点体现形式
// in-memory copy of an inode
struct inode {
  uint dev;           // Device number
  uint inum;          // Inode number
  int ref;            // Reference count
  int flags;          // I_BUSY, I_VALID

      // 下面这些编程都是dinode的拷贝
      // copy of disk inode
  short type;
  short major;
  short minor;
  short nlink;
  uint size;
  uint addrs[NDIRECT+1];
};
#define I_BUSY 0x1
#define I_VALID 0x2

// table mapping major device number to device functions
struct devsw {
  int (*read)(struct inode*, char*, int);
  int (*write)(struct inode*, char*, int);
};

extern struct devsw devsw[];

#define CONSOLE 16.ide.c:磁盘IO的具体实现,xv6维护了一个进程请求磁盘操作的队列(idequeue)。当进程调用**void iderw(struct buf *b)**请求读写磁盘时,该请求被加入等待队列idequeue,同时进程进入睡眠状态。当一个磁盘读写操作完成时,会触发一个中断,中断处理程序ideintr()会移除队列开头的请求,唤醒队列开头请求所对应的进程。
// idequeue points to the buf now being read/written to the disk.
// idequeue->qnext points to the next buf to be processed.
// You must hold idelock while manipulating queue.

static struct spinlock idelock; // 保护 idequeue
static struct buf *idequeue; // 磁盘读写操作的请求队列
……
// 等待磁盘进入空闲状态
// Wait for IDE disk to become ready.
static int idewait(int checkerr)
{
  ……
  //
  while(((r = inb(0x1f7)) & (IDE_BSY|IDE_DRDY)) != IDE_DRDY);
  ……
}

// 初始化IDE磁盘IO
void ideinit(void)
{
  ……
}

// 开始一个磁盘读写请求
// Start the request for b.  Caller must hold idelock.
static void idestart(struct buf *b)
{
  ……
}

// 当磁盘请求完成后中断处理程序会调用的函数
// Interrupt handler.
void ideintr(void)
{
  …… // 处理完一个磁盘IO请求后,唤醒等待在等待队列头的那个进程
  wakeup(b);

  // 如果队列不为空,继续处理下一个磁盘IO任务
  // Start disk on next buf in queue.
  if(idequeue != 0)
    idestart(idequeue);
  ……
}

//PAGEBREAK!  上层文件系统调用的磁盘IO接口
// Sync buf with disk.
// If B_DIRTY is set, write buf to disk, clear B_DIRTY, set B_VALID.
// Else if B_VALID is not set, read buf from disk, set B_VALID.
void iderw(struct buf *b)
{
  …… // 竞争锁
  acquire(&idelock);  //DOC:acquire-lock

  // Append b to idequeue.
  b->qnext = 0;
  for(pp=&idequeue; *pp; pp=&(*pp)->qnext)  //DOC:insert-queue
    ;
  *pp = b;

  // Start disk if necessary.  开始处理一个磁盘IO任务
  if(idequeue == b)
    idestart(b);

  // Wait for request to finish.  睡眠等待
  while((b->flags & (B_VALID|B_DIRTY)) != B_VALID){
    sleep(b, &idelock);
  }

  release(&idelock);  // 释放锁
}7.bio.c:Buffer Cache的具体实现。因为读写磁盘操作效率不高,根据时间与空间局部性原理,这里将最近经常访问的磁盘块缓存在内存中。主要接口有struct buf* bread(uint dev, uint sector)、void bwrite(struct buf *b),bread会首先从缓存中去寻找块是否存在,如果存在直接返回,如果不存在则请求磁盘读操作,读到缓存中后再返回结果。bwrite直接将缓存中的数据写入磁盘。 8.log.c:该模块主要是维护文件系统的一致性。引入log模块后,对于上层文件系统的全部磁盘操作都被切分为transaction,每个transaction都会首先将数据和其对应磁盘号写入磁盘上的log区域,且只有在log区域写入成功后,才将log区域的数据写入真正存储的数据块。因此,如果在写log的时候宕机,重启后文件系统视为该log区的写入不存在,如果从log区写到真实区域的时候宕机,则可根据log区域的数据恢复。 9.sysfile.c:主要定义了与文件相关的系统调用。主要接口及含义如下:
// Allocate a file descriptor for the given file.
// Takes over file reference from caller on success.
static int fdalloc(struct file *f)
{
  …… // 申请一个未使用的文件句柄
}

int sys_dup(void)
{
  …… // 调用filedup对文件句柄的引用计数+1
  filedup(f);
  return fd;
}

int sys_read(void)
{
  …… // 读取文件数据
  return fileread(f, p, n);
}

int sys_write(void)
{
  …… // 向文件写数据
  return filewrite(f, p, n);
}

int sys_close(void)
{
  …… // 释放文件句柄资源
  fileclose(f);
  return 0;
}

int sys_fstat(void)
{
  …… // 修改文件统计信息
  return filestat(f, st);
}

// Create the path new as a link to the same inode as old.
int sys_link(void)
{
  …… // 为已有的inode创建一个新名字
}

//PAGEBREAK!
int sys_unlink(void)
{
  …… // 解除inode中的某个名字, 若名字全被移除, inode回被释放
}

static struct inode* create(char *path, short type,
        short major, short minor)
{
  …… //
}

int sys_mkdir(void)
{
  …… // 创建一个目录
}

int sys_mknod(void)
{
  …… // 创建一个新文件
}

int sys_chdir(void)
{
  …… // 切换目录
}

int sys_pipe(void)
{
  …… // 创建一个管道文件
}10.exec.c:只有一个exec接口,实质就是传入elf格式的可执行文件,装载到内存并分配内存页,argv是一个指针数组,用于携带参数。
int exec(char *path, char **argv)
{
  …… // 判断文件是否存在
  if((ip = namei(path)) == 0)
    return -1;
  ilock(ip);
  pgdir = 0;

  // Check ELF header  检查elf头是否合法
  if(readi(ip, (char*)&elf, 0, sizeof(elf)) < sizeof(elf))
    goto bad;
  ……

  // Load program into memory.
  sz = 0;
  for(i=0, off=elf.phoff; i<elf.phnum; i++, off+=sizeof(ph)){
    if(readi(ip, (char*)&ph, off, sizeof(ph)) != sizeof(ph))
      goto bad;
    if(ph.type != ELF_PROG_LOAD)
      continue;
    if(ph.memsz < ph.filesz)
      goto bad;
    if((sz = allocuvm(pgdir, sz, ph.vaddr + ph.memsz)) == 0)
      goto bad;
    if(loaduvm(pgdir, (char*)ph.vaddr, ip, ph.off, ph.filesz) < 0)
      goto bad;
  }
  iunlockput(ip);
  ip = 0;

  // Allocate two pages at the next page boundary.
  // Make the first inaccessible.  Use the second as the user stack.
  sz = PGROUNDUP(sz);
  if((sz = allocuvm(pgdir, sz, sz + 2*PGSIZE)) == 0)
    goto bad;
  clearpteu(pgdir, (char*)(sz - 2*PGSIZE));
  sp = sz;

  // Push argument strings, prepare rest of stack in ustack.
  for(argc = 0; argv[argc]; argc++) {
    if(argc >= MAXARG)
      goto bad;
    sp = (sp - (strlen(argv[argc]) + 1)) & ~3;
    if(copyout(pgdir, sp, argv[argc], strlen(argv[argc]) + 1) < 0)
      goto bad;
    ustack[3+argc] = sp;
  }
  ……

 bad:
  if(pgdir)
    freevm(pgdir);
  if(ip)
    iunlockput(ip);
  return -1;
}